基于分层解耦的无文本零样本语音情感迁移
中国多媒体大会(ChinaMM 2025).
主要贡献。 提出TZET方法,通过分层特征解耦(HuBERT+Wav2vec2.0+对抗训练)和端到端VITS框架实现无文本零样本语音情感迁移,在情感准确度上较FreeVC提升10.4%
研究概述
TZET通过三路独立预训练模块(HuBERT语义编码器/说话人编码器/Wav2vec2.0情感单元)分别解耦语义、身份与情感特征,结合对抗训练约束正交性,利用梅尔谱图缩放和交叉注意力F0预测增强鲁棒性,最终基于端到端VITS框架融合四元特征实现高质量零样本情感语音转换。
研究问题
现有零样本语音转换研究忽视情感传递;转换模型与声码器独立训练导致合成语音失真;基于IN的方法过度消除副语言信息导致情感韵律损失;基于VQ的方法受限于码本离散性引发自然度退化。
核心思路
构建内容-说话人-情感三元特征的联合解耦框架,通过对抗训练约束说话人与情感嵌入空间的正交性,基于端到端VITS框架将声学建模与波形生成统一优化,消除级联系统的特征分布偏差,实现无文本零样本情感迁移。
关键组成
- 分层解耦
内容-说话人-情感三元特征解耦
- 基于HuBERT提取语义内容(第9层512维隐藏状态+K-Means量化),双向LSTM说话人编码器提取256维说话人嵌入,Wav2vec2.0+CondConv提取情感特征。通过情感对抗损失(L_Spk - lambda*L_Emo)约束正交性,确保三者独立建模。
- F0预测
交叉注意力驱动的音高轮廓预测
- 利用交叉注意力机制构建情感驱动的动态基频预测网络,以语义内容特征为查询向量,说话人+情感特征为键值对,实现情感相关F0轮廓的自适应建模,增强零样本条件下的音高动态捕捉能力。
- 端到端VITS
无文本端到端语音合成框架
- 基于VITS框架构建四元特征(Z_C语义+Z_F音高+Z_E情感)融合通道,通过后验编码器+归一化流+解码器联合优化,避免传统级联系统的声学特征与声码器分布不一致问题,支持音频到音频的直接转换。
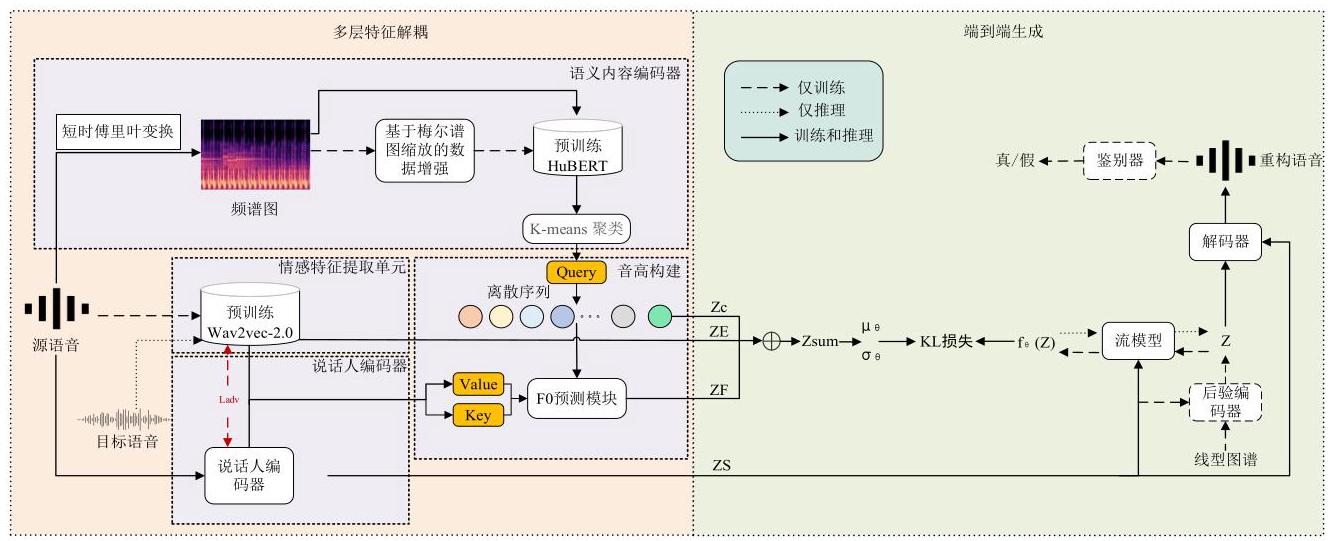
训练采用双任务协同:(1)语音重建任务(使用源情感嵌入)优化特征解耦与重组;(2)语音转换任务(使用目标情感嵌入)验证情感迁移。F0和情感来自目标音频,内容和说话人来自源语音。总损失包括重构损失、对抗损失(G/D)、说话人/情感对抗损失和F0损失。
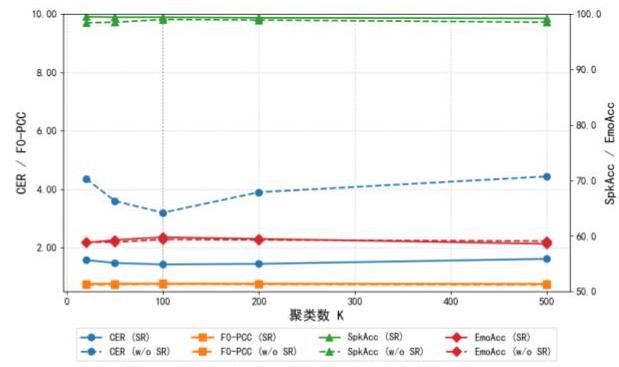
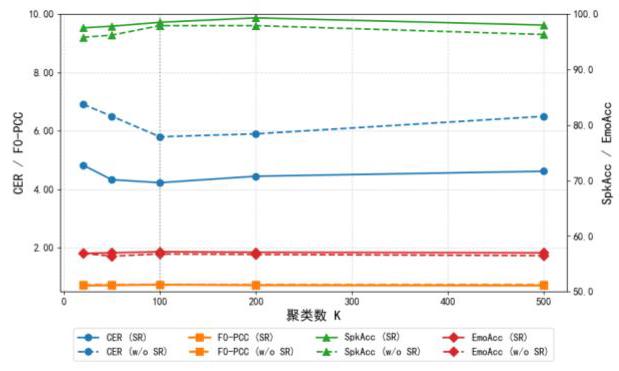
HuBERT第9层隐藏状态经K-Means(K=100)量化为离散语义令牌。梅尔谱图缩放(SR)策略从U(0.85,1.15)采样缩放系数r,对Mel谱图频率轴压缩或拉伸,实现双重增益:(1)学习鲁棒深层语义特征降低说话人依赖;(2)缓解未知说话人场景下的语义丢失。
Wav2vec2.0情感提取单元通过逐层叠加融合多层隐藏状态,经1D卷积(kernel=5)+ReLU+全局平均池化+FC输出情感表征。CondConv机制基于情感标签动态生成卷积核参数,固定部分权重作为身份特征锚点,实现层次化特征分离。
实验结果
- ESD (说话人已知+情感已知)
- 59.8% Emo.Acc.
- 比FreeVC(49.4%)提升10.4%
- 情感准确率显著优于所有基线
- ESD (说话人已知+情感已知)
- 99.4% Spk.Acc.
- 比ZEST(98.9%)提升0.5%
- 说话人准确率最优
- ESD (说话人已知+情感已知)
- 1.43% CER
- 比ZEST(5.4%)降低3.97%,比FreeVC(1.53%)更优
- 字符错误率最低,语音清晰度最好
- ESD (说话人未知+情感已知)
- 57.2% Emo.Acc.
- 比FreeVC(46.8%)提升10.4%
- 零样本说话人场景下仍保持优势
| Method | CER% | F0-PCC | Spk.Acc.% | Emo.Acc.% |
|---|---|---|---|---|
| FreeVC | 1.53 | 0.778 | 99.3 | 49.4 |
| ZEST | 5.4 | 0.754 | 98.9 | 59.0 |
| TZET(w/o F0) | 2.49 | - | 99.2 | 53.3 |
| TZET(w/o SR) | 3.2 | 0.761 | 99.0 | 58.4 |
| TZET | 1.43 | 0.772 | 99.4 | 59.8 |
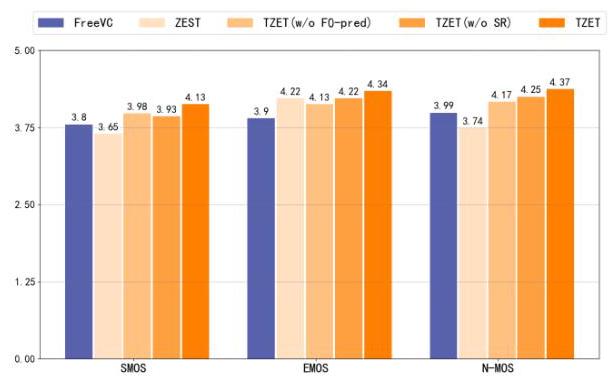
TZET在已知/未知说话人及情感场景下均展现优势:情感准确率较FreeVC提升10.4%,说话人准确率达99.4%(较ZEST提升0.5%),CER降至1.43%(较ZEST降低3.97%)。消融实验证实对抗损失对说话人/情感解耦贡献最大,F0预测模块增强情感表征完整性,SR数据增强有效抑制内容失真。
结论
TZET通过分层特征解耦与端到端无文本合成机制,利用自监督学习和对抗损失将情感特征与语义内容、说话人特征解耦,梅尔谱图缩放缓解语义内容缺失并增强未知说话人泛化能力,交叉注意力F0预测进一步提升情感迁移鲁棒性。实验表明TZET在说话人、情感迁移准确性和语音清晰度方面具有显著优势。
核心结论。 内容-说话人-情感三元特征联合解耦+对抗训练正交约束是零样本情感迁移的有效策略。端到端VITS框架消除了级联系统的特征分布偏差问题,四元特征(语义/说话人/情感/音高)融合通道实现了高质量的情感语音转换。
BibTeX
@inproceedings{zhen2025tzet,
  title={基于分层解耦的无文本零样本语音情感迁移},
  author={甄怡宁 and 王春玲 and 杨昊田 and 王少荣},
  booktitle={中国多媒体大会(ChinaMM 2025)},
  year={2025}
}